 par
La veille IA de la semaine 39, du 20 au 26 septembre 2026, tient presque dans une seule journée : le mardi 22 septembre. Anthropic lance Claude Opus 5.5 à un tarif inférieur à celui d’Opus 5. Environ quatre-vingt-dix minutes plus tard, OpenAI divise par deux le prix de GPT-6 Sol et GPT-6 Luna. Le même jour, Xiaomi publie MiMo-V2.6-Pro, qui devient le meilleur modèle en poids ouverts du classement Artificial Analysis, pour environ 0,13 dollar par tâche.
Pendant ce temps, l’agent IA change de corps. Meta lui donne un objet de poche, Alibaba l’installe au cœur du système d’un smartphone, Amazon ouvre les outils de ses vendeurs à Claude, Ant Group réorganise Alipay autour du commerce agentique.
Une inférence moins chère rend économiquement possibles des agents qui tournent en continu, gardent une mémoire et agissent… sous forme d’avatars. C’est la réalité désormais.
Au sommaire
Deux mouvements, un seul mécanisme
Le mécanisme est simple et c’est celui déjà à l’oeuvre la semaine passée (voir ma veille IA de la semaine 38). Un chatbot consomme des tokens quand on lui pose une question. Un agent en consomme en permanence : il relit son contexte à chaque étape, appelle des outils, vérifie, recommence. Quand le prix du token baisse et que la relecture du contexte mis en cache devient presque gratuite, ce mode de fonctionnement cesse d’être un luxe de laboratoire. La guerre des prix n’est donc pas un épisode commercial isolé. C’est la condition économique de l’agent persistant.
Je crois donc que la compétition ne porte plus seulement sur la performance d’un modèle, mais sur le coût d’exécution d’un travail complet, et c’est ce coût qui décidera de la vitesse à laquelle les agents entreront dans les organisations.
Guerre des prix de l’IA : ce qui a changé le 22 septembre
OpenAI et Anthropic, à quatre-vingt-dix minutes d’intervalle
OpenAI a publié GPT-6 Sol et GPT-6 Luna, deux modèles placés sous GPT-6 Astra, le modèle phare sorti le 3 septembre. Sol coûte 2 dollars par million de tokens en entrée et 10 dollars en sortie, contre 4 et 20 dollars pour GPT-5.6 Sol. Luna descend à 0,10 et 0,50 dollar, contre 0,20 et 1,20 dollar. L’entreprise attribue ces baisses à des gains sur le cache et l’inférence, et un porte-parole a confirmé à VentureBeat qu’il s’agit de tarifs permanents, pas d’une promotion. Précision utile : la baisse de 50 % est calculée par rapport aux tarifs promotionnels de la génération GPT-5.6.
Anthropic avait publié Claude Opus 5.5 environ quatre-vingt-dix minutes plus tôt, selon TechCrunch cité par Quartz. Le tarif passe à 4 dollars en entrée et 20 dollars en sortie, contre 5 et 25 dollars pour Opus 5 : une baisse de 20 % du prix affiché. La lecture du cache, qui pèse lourd dans les sessions d’agents, baisse de 60 % pour atteindre 0,20 dollar par million de tokens. Anthropic annonce un coût d’exécution inférieur d’environ 40 % à celui d’Opus 5 sur des charges typiques, parce que le modèle consomme aussi moins de tokens pour la même tâche, et le positionne au niveau de Claude Fable 5.1 sur la plupart des travaux.
Ces chiffres appellent deux précautions. Les 40 % d’Anthropic sont une estimation de l’éditeur, mesurée au niveau d’effort par défaut de chaque modèle, moyen pour Opus 5.5 et élevé pour Opus 5. Et la baisse de prix ne garantit pas une progression uniforme : sur le benchmark d’usage d’ordinateur OSWorld 2.0, GPT-6 Sol obtient 60,5 % contre 65,7 % pour GPT-5.6 Sol, d’après les résultats relayés par Yahoo Finance. Moins cher ne veut pas dire meilleur partout.
La veille, le 21 septembre, xAI avait lancé Grok 4.7 en conservant le tarif de Grok 4.6, soit 2 dollars en entrée et 6 dollars en sortie. Sur l’Intelligence Index d’Artificial Analysis, il obtient 46 points, contre 53 pour GPT-6 et Claude Fable 5.1, selon The Decoder. Aucun acteur américain ne peut plus ignorer le plancher tarifaire.
Step 5 et MiMo-V2.6-Pro : les modèles chinois déplacent le plancher
StepFun a lancé Step 5 Preview le 18 septembre. Ce modèle mixture-of-experts de 600 milliards de paramètres, dont 27 milliards actifs par token, obtient 44 points sur l’Intelligence Index et revient à environ 0,71 dollar par tâche d’évaluation selon Artificial Analysis. Le prix affiché est de 1 dollar en entrée et 2,70 dollars en sortie, mais le modèle est très bavard : 160 millions de tokens de sortie sur l’ensemble de l’évaluation, contre une médiane proche de 90 millions pour les modèles comparables. StepFun annonce la publication des poids pour le 15 octobre.
Xiaomi va plus loin avec MiMo-V2.6-Pro, publié le 22 septembre sur Hugging Face sous licence MIT. Le modèle compte 1,02 billion de paramètres, dont 42 milliards actifs, accepte texte, image, audio et vidéo, et gère un contexte d’un million de tokens. Artificial Analysis lui attribue 46 points, le meilleur score parmi les 114 modèles en poids ouverts qu’il suit, pour environ 0,13 dollar par tâche.
Sur le même classement, Claude Fable 5.1 revient à 7,63 dollars par tâche, soit près de soixante fois plus, selon les chiffres relayés par OfficeChai. Xiaomi indique aussi que sa phase d’apprentissage par renforcement a duré moins de six jours pour environ 2,62 millions de dollars, et publie avec le modèle un rapport technique et des milliers d’environnements d’entraînement.
Prix affiché, coût par tâche, coût réel : trois chiffres à ne pas confondre
Ces chiffres ne sont pas interchangeables. Le prix par million de tokens indique combien coûte une unité. Le coût par tâche d’Artificial Analysis indique combien coûte un exercice de benchmark, verbosité comprise : c’est pour cela que Step 5, bon marché au token, perd une partie de son avantage à la tâche. Aucun des deux ne dit combien coûte un résultat accepté dans votre organisation.
Le coût réel ajoute l’hébergement, la latence, la redondance, la supervision humaine, la sécurité et surtout les reprises après erreur. Un modèle à 0,13 dollar la tâche devient cher s’il échoue souvent sur un processus critique. Un modèle à 7 dollars peut devenir économique s’il évite une erreur coûteuse. Dernière nuance : GPT-6 Luna revient à 0,07 dollar par tâche sur le même index, pour un score de 41. La frontière entre prix et performance compte plusieurs points d’équilibre, pas un seul gagnant.
Modèles en poids ouverts : le trafic ne fait pas encore le revenu
Le rapport State of Open Source AI v1.1 de Mozilla, publié le 15 septembre, éclaire ce qui se joue derrière les prix. Sur OpenRouter, en août 2026, huit des dix modèles les plus utilisés en volume de tokens étaient en poids ouverts, dont sept conçus en Chine. DeepSeek est devenu le premier modèle ouvert à mener les requêtes hebdomadaires de la plateforme, à partir du 3 août, après cinquante et une semaines de domination de Google.
Pourtant, les modèles ouverts ne captent qu’environ 4 % du revenu de la couche modèle. Attention, ce chiffre porte sur une fenêtre ancienne, de mai à septembre 2025, la dernière pour laquelle une répartition des revenus a été publiée. Le rapport reprend aussi une estimation de 24,8 milliards de dollars d’économies annuelles non réalisées. Côté entreprises, l’enquête conduite avec SlashData montre que 79 % des développeurs utilisent des modèles ouverts, mais que seuls 51 % des projets ouverts atteignent la production, contre 63 % pour les modèles fermés.
Ce paradoxe est central pour un décideur. OpenRouter mesure un canal particulier, fréquenté par des développeurs qui comparent et routent déjà plusieurs modèles. Il ne représente ni les contrats privés, ni les offres intégrées aux grands clouds. Les modèles fermés monétisent l’intégration, le support, les garanties contractuelles et la réduction du risque perçu. Les poids ouverts gagnent l’essai, parfois l’usage, rarement la facture.
Un détail rend la question plus politique qu’elle n’en a l’air : la couche de distribution de l’open source change de mains. Nvidia a annoncé le 3 septembre le rachat de Hugging Face pour 12,93 milliards de dollars, et Stripe celui d’OpenRouter en août, selon TechTimes. Des poids ouverts distribués par des plateformes américaines ne suffisent pas, à eux seuls, à garantir une autonomie de décision.
Agents IA : l’agent quitte la fenêtre du chatbot
Meta Connect 2026 : un agent personnel et un objet pour lui parler
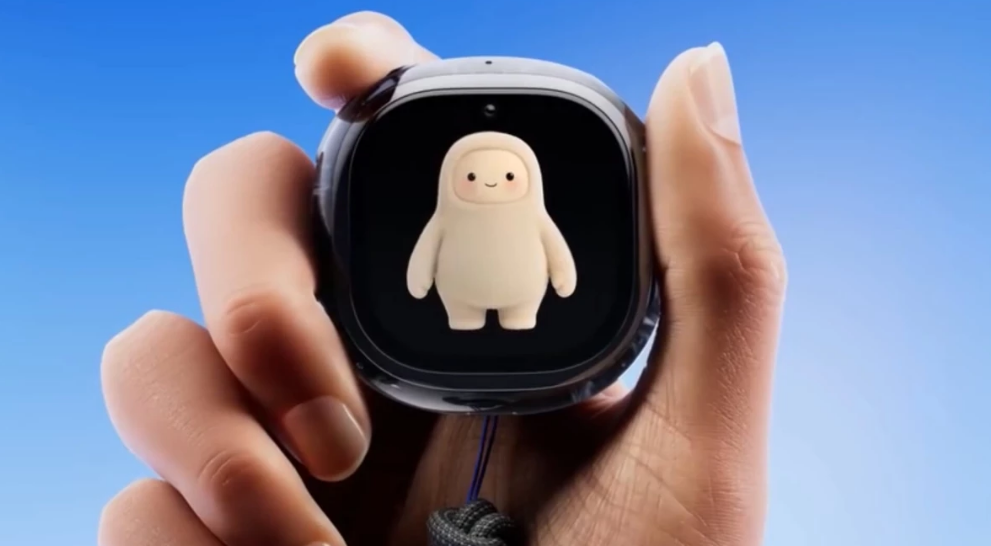
Lors de Connect 2026, le 23 septembre, Meta a placé Muse, son agent personnel lancé début septembre, au centre de sa stratégie matérielle. Selon les annonces officielles, Muse arrivera sur les lunettes IA de Meta dans les prochains mois, s’enrichit de connecteurs commerciaux (Walmart, Best Buy, Sephora, Wayfair, Shop Pay, PayPal) et professionnels (Notion, GitHub, Box), et disposera d’un objet dédié, le Muse Charm. Ce boîtier de poche, au format porte-clés, repose sur un modèle vocal en temps réel. Meta n’a communiqué ni prix ni date précise ; Mark Zuckerberg vise une disponibilité pour les fêtes de fin d’année. Les Ray-Ban Meta Gen 3 sont, elles, disponibles dès maintenant.
Le modèle économique est assumé : une version gratuite, avec l’intention de se rémunérer à terme par une petite commission sur les transactions, selon AI Magazine. La frontière entre plateformes apparaît déjà : Amazon a bloqué l’accès de Muse en début de semaine, d’après Axios cité par The Rundown.
Google CC : un agent pour un foyer, pas pour une personne
Google Labs a transformé CC, le 17 septembre, en agent partagé pour les familles. Jusqu’à six membres peuvent y contribuer. L’agent dispose de son propre compte Google, ne voit que ce que chaque membre choisit de lui transmettre (un courriel de l’école, un dossier Drive, un agenda), produit un brief quotidien commun et peut préremplir des formulaires d’inscription ou vérifier des temps de trajet. Chaque instance tourne sur un ordinateur cloud isolé, piloté par le harnais agentique Antigravity et les derniers modèles Gemini.
Le changement d’échelle compte davantage que la fonctionnalité. Un chatbot répond à une personne. Un agent familial arbitre entre plusieurs personnes : qui voit quoi, qui corrige une information erronée, quelle consigne prévaut quand deux membres demandent l’inverse. Ce sont exactement les questions qu’une entreprise devra trancher pour ses propres agents d’équipe.
Qwen Intelligence : l’agent devient une couche du smartphone
Lors de sa conférence Apsara, le 22 septembre à Hangzhou, Alibaba a présenté Qwen Intelligence, une plateforme complète destinée aux fabricants de smartphones. Elle réunit des modèles optimisés pour le mobile, une couche d’orchestration et trois agents : un planificateur qui décompose une demande, par exemple l’organisation d’un déplacement, un agent d’exécution qui passe d’abord par les interfaces des applications (MCP, liens profonds, lignes de commande) et ne reproduit des gestes qu’en dernier recours, et un agent créatif.
Les décisions à risque, comme un paiement ou une suppression, sont renvoyées à l’utilisateur. Honor sera le premier à l’intégrer, avec la série Magic9 attendue le 28 septembre. Alibaba revendique jusqu’à 91,8 % de réussite sur des enchaînements de plus de cent étapes, un chiffre interne non vérifié de façon indépendante.
Ant Group et Amazon : le commerce se prépare aux agents
Ant Group a regroupé les activités d’Alipay dans une seule unité tournée vers le commerce agentique, rapporte Forkast. Son assistant Ah Bao, lancé en juin, donne accès par la conversation à plus de 10 000 services, et les paiements exigent une confirmation explicite de l’utilisateur. Selon une note de CITIC Securities, le service AI Pay avait déjà traité 300 millions de transactions initiées par des agents à fin mai 2026.
Amazon a choisi une autre voie lors de sa conférence vendeurs Accelerate, le 23 septembre. Son Seller Assistant gagne une mémoire persistante et des flux de travail permanents, et un nouveau plugin Selling Partner l’ouvre à des assistants extérieurs : Amazon Quick au lancement et Claude en bêta, pour les vendeurs des boutiques américaines. L’assistant prépare les modifications de prix, de stock ou de fiches produits, que le vendeur valide. Point décisif relevé dans l’aide Seller Central : une fois l’assistant tiers connecté, les données relèvent de ses propres conditions, et le vendeur reste responsable de ce que l’agent fait sur son compte.
Ce que ces annonces prouvent, et ce qu’elles ne prouvent pas
Ces annonces prouvent que les plateformes construisent l’infrastructure de l’agent persistant : identité propre, mémoire, connecteurs, droits d’action, confirmation humaine. Elles ne prouvent pas que les utilisateurs délégueront réellement leurs décisions. L’adoption dépendra de variables très classiques : utilité perçue, friction d’usage, confiance. Un objet de plus à recharger, ou un agent qui se trompe une seule fois sur un paiement, peut suffire à freiner l’usage.
La leçon la plus concrète vient d’Amazon, qui ouvre ses outils à Claude tout en bloquant Muse. Les plateformes ne se contentent pas de proposer leur propre agent : elles choisissent quels agents extérieurs ont le droit d’entrer. Pour une marque ou un vendeur, être correctement compris, comparé et sélectionné par un agent devient un sujet aussi stratégique que le référencement. J’en tirais déjà les conséquences sur les modèles de facturation dans mon article sur la machine economy et la fin possible de la facturation au temps.
Anthropic : l’accélération sous contrôle revendiqué
Anthropic concentre les tensions de la semaine. Le 12 septembre, Dario Amodei publiait We Must Pace the Frontier, un essai qui appelle l’industrie à ralentir le rythme d’amélioration des capacités, sans l’arrêter, selon un plan en trois étapes. Anthropic s’est engagée unilatéralement sur la première : donner à des évaluateurs tiers un accès permanent à ses systèmes, comparable à celui d’un salarié. Deux semaines plus tard, l’entreprise baisse ses prix, publie une découverte réalisée par un essaim d’agents et signe le plus gros contrat de l’histoire d’Akamai.
Claude « mène » 26 % de la R&D d’Anthropic : que mesure ce chiffre ?
Le 17 septembre, Anthropic a publié un indice d’automatisation de sa R&D. Selon ce cadre, construit sur une échelle proposée par Epoch AI, Claude « mène » 26 % du travail de R&D, pondéré par le temps que les équipes y consacrent, en août 2026, contre moins de 1 % en février. « Mener » signifie ici réaliser l’essentiel d’une tâche de bout en bout à partir d’une consigne générale, sous la supervision d’un humain. Claude participe à plus de 90 % des travaux, environ 30 000 agents tournent simultanément sur la plateforme interne, et près de 6 % du calcul consacré à la R&D va à la sécurité, selon Quartz.
La prudence s’impose. Ces chiffres sont déclarés par l’entreprise, ils ne sont pas audités, et les niveaux d’automatisation ont largement été évalués par Claude lui-même, relève Implicator. Ils restent un signal organisationnel majeur : le fabricant de Claude réorganise déjà sa propre production autour de Claude.
950 agents, 21 heures, un système enzymatique inconnu
Le 23 septembre, Anthropic a annoncé que son nouveau laboratoire de sciences du vivant avait identifié un système enzymatique inédit dans l’ADN de bactériophages. Environ 950 agents Claude ont travaillé 21 heures et consommé 210 millions de tokens : ils ont rassemblé plus de 200 000 transcriptases inverses, isolé 3 500 systèmes candidats, puis rédigé des rapports sur les vingt plus prometteurs. Le système retenu, baptisé ART, associe une transcriptase inverse à une série de séquences répétées qui rappelle CRISPR. Les humains ont fixé la consigne initiale et mené les expériences de laboratoire.
Trois limites encadrent ce résultat. La prépublication n’a pas été relue par des pairs. La fonction du système reste inconnue. Et la méthode, la fouille des voisinages génomiques, est employée depuis des décennies, a rappelé Lucas Harrington, cofondateur de Mammoth Biosciences, tandis que Feng Zhang (MIT, Broad Institute) juge la découverte intrigante. L’expérience établit une faisabilité : un essaim d’agents peut trier un espace de recherche immense et faire remonter une anomalie exploitable. Elle n’établit pas une supériorité générale sur une équipe humaine ou sur une autre architecture.
Akamai : 11,6 milliards de dollars pour des CPU, pas des GPU
Le 24 septembre, Akamai a annoncé un engagement contractuel d’Anthropic de 11,6 milliards de dollars sur sept ans pour son cloud distribué, extensible de 9 milliards, soit environ 20 milliards au total. Le contrat porte sur des processeurs généralistes (CPU). Il reste conditionnel : selon le dépôt réglementaire relayé par TechCrunch, il dépend d’exigences de livraison et de disponibilité, et chaque partie peut y mettre fin dans certaines conditions. Akamai prévoit environ 5,5 milliards de dollars d’investissements et accorde à Anthropic un bon de souscription portant jusqu’à environ 5 % de son capital.
Le choix du CPU est le vrai signal. Un agent ne se résume pas à son modèle : l’orchestration, les appels d’outils, la navigation web, les contrôles et la journalisation tournent souvent sur des processeurs classiques. Le coût d’un système agentique dépend donc de la bonne répartition de chaque étape sur l’infrastructure adaptée. Et un essaim de 950 agents montre à quel point la baisse du prix unitaire change l’économie d’une expérience entière.
Le paradoxe d’Anthropic n’est donc pas « ralentir tout en accélérant ». Il est plus exigeant : industrialiser vite des agents et leur infrastructure tout en demandant un contrôle plus fort de la frontière. Cette position peut être cohérente. Elle doit maintenant devenir vérifiable, et les évaluateurs embarqués promis en seront le premier test.
Infrastructure IA : la limite redevient physique
Le prix facturé baisse, mais le coût physique du calcul se rappelle à tout le monde.
Le 24 septembre, Bloomberg a révélé qu’Oracle avait adressé une notification de force majeure au développeur de Project Jupiter, un campus Stargate de 2,45 GW au Nouveau-Mexique. Oracle ne quitte pas le projet : la notification lui permettrait de repousser ses loyers si le site ne démarre pas en 2028 comme prévu. En cause, l’énergie. Le gazoduc qui doit alimenter les piles à combustible du site a pris près de six mois de retard, au 1er février 2027, et un permis sur la qualité de l’air attend une décision d’ici le 23 novembre. Oracle assure que le calendrier tient.
Au Texas, le gouverneur Greg Abbott a ordonné le 21 septembre à l’agence environnementale de l’État de suspendre tous les permis de centres de données jusqu’à la fin de l’audit conduit par ERCOT, le gestionnaire du réseau électrique. BloombergNEF estimait en août que près de 50 GW de projets, soit environ 20 % du pipeline américain de 253 GW, étaient exposés à ce gel. L’agence doit rendre compte au gouverneur le 19 octobre, et ERCOT prévoit son rapport d’ici le 10 décembre.
Côté modèles, Koray Kavukcuoglu, nouveau patron de Google DeepMind, a indiqué le 23 septembre que Gemini 4 était entré en début de post-entraînement et sortirait bien avant la fin de l’année. Aucune date n’a été donnée : octobre relève encore de la spéculation. Google devra de toute façon se mesurer à un rapport performance-prix qui vient de bouger.
Ces signaux n’établissent pas une pénurie mondiale. Ils montrent que l’énergie, le raccordement, l’eau et l’acceptabilité locale deviennent des contraintes de premier rang, comme je le relevais déjà dans la veille de la semaine 36 sur la bataille de l’infrastructure. Un fournisseur peut baisser ses prix grâce au cache, à la compression des modèles ou à une marge réduite. Il ne supprime ni les mégawatts, ni les délais administratifs. L’agent paraît plus léger dans la poche ; son infrastructure devient plus lourde derrière lui.
Chine : les poids ouverts avancent, toute la pile reste sous contrainte
La provenance, angle mort du succès de Xiaomi
Le succès de MiMo-V2.6-Pro arrive dans un contexte chargé. Le 10 septembre, le rapport de menaces d’Anthropic, dont je parlais dans la veille de la semaine 37 sur la confiance comme infrastructure, accusait sept laboratoires chinois (Alibaba, Moonshot, DeepSeek, Zhipu, MiniMax, SenseTime et Xiaomi) de distillation illicite de Claude au moyen de faux comptes.
Pour Xiaomi, Anthropic décrit plus de 400 000 échanges passés par environ 1 500 comptes en vingt jours, en mars et avril 2026. Xiaomi n’a pas répondu publiquement, et aucun élément public ne relie à ce stade MiMo-V2.6 à des données issues de Claude. C’est une allégation, pas un fait établi. Pour une organisation qui envisage ce modèle, cette incertitude sur la provenance doit entrer dans l’évaluation au même titre que la latence ou le prix.
Pékin retourne l’enquête contre DeepSeek et Moonshot
Retournement notable : l’Administration chinoise du cyberespace enquête désormais sur DeepSeek et Moonshot, selon The Information puis MLex. Son inquiétude porte sur des données d’utilisateurs chinois, potentiellement sensibles, qui auraient transité vers des serveurs américains à l’insu des utilisateurs. Anthropic attribue aux deux entreprises plus de 35 millions d’interactions avec Claude, dont plus de 23 millions pour Moonshot et plus de 12 millions pour DeepSeek. Aucune sanction n’a été prononcée. Trois statuts doivent rester séparés : l’enquête est rapportée par la presse, les volumes sont des allégations d’Anthropic, et la responsabilité des entreprises n’est pas établie.
Le silicium chinois accélère, la mémoire freine
Alibaba a présenté à Apsara le Zhenwu V900, conçu par sa filiale T-Head : trois fois les performances du Zhenwu M890 selon l’entreprise, 216 Go de mémoire, 1,2 To/s de bande passante entre puces, et une production de masse annoncée pour le premier trimestre 2027. Alibaba vise plus de 20 GW de capacité de centres de données d’ici 2032 et confirme que Qwen 4 est en cours d’entraînement.
Quelques jours plus tôt, lors de Huawei Connect le 17 septembre, Huawei avait avancé l’Ascend 960DT au premier trimestre 2027, trois trimestres plus tôt que prévu, et présenté Peerium, une architecture conçue pour faire fonctionner jusqu’à un million de processeurs comme une seule machine. La demande intérieure absorbe déjà les volumes de Huawei, qui n’envisage pas de lancement international large.
La contrainte, c’est la mémoire à haute bande passante (HBM). Reuters rapportait le 10 septembre que le prix indicatif de l’Ascend 950DT dépassait 250 000 yuans, en hausse de 20 à 50 % en deux mois, et que Cambricon avait suivi. La Chine avance en même temps sur les modèles, les terminaux et les puces. Mais un prix bas au token accélère l’essai ; l’adoption durable dépendra de toute la pile.
Mistral AI : modèle, usages et infrastructure commencent à se rejoindre
Je dois déclarer ici un intérêt : NEOMA Business School est partenaire de Mistral AI. Cette relation m’oblige d’autant plus à distinguer ce qui est annoncé de ce qui est livré.
Mistral a confirmé en début de semaine le rachat de Pimento, start-up parisienne qui génère des créations publicitaires à partir d’un brief, de l’identité d’une marque et des données de campagne, et qui travaille avec plus de 180 marques. C’est sa troisième acquisition de 2026, après Koyeb pour l’infrastructure et Emmi AI pour l’ingénierie industrielle. Le prix n’est pas confirmé : environ 3,8 millions d’euros selon L’Informé, 12,7 millions en numéraire et en actions selon Sifted. L’équipe rejoint Vibe, l’assistant de Mistral, anciennement Le Chat. Le devenir du produit Pimento n’est pas précisé.
L’Agence spatiale européenne a annoncé le 23 septembre une lettre d’intention signée le 16 septembre à Paris par Josef Aschbacher et Arthur Mensch. Il s’agit d’un cadre de coopération, pas d’un contrat chiffré, qui prolonge des outils déjà utilisés comme l’assistant d’ingénierie Orbit. Enfin, Arthur Mensch a annoncé un nouveau modèle dans les prochaines semaines et plaidé pour des garanties publiques facilitant le financement de centres de données en Europe, selon ElectronLibre, après la levée de 3 milliards d’euros bouclée début septembre.
Ces trois informations dessinent une stratégie : une brique métier, une référence institutionnelle, une capacité physique. Elles ne prouvent encore ni l’intégration du produit, ni la qualité d’un déploiement, ni l’existence d’un centre de données supplémentaire. Le soutien public pose aussi une question de gouvernance : si l’État garantit une infrastructure stratégique, les contreparties doivent être lisibles, qu’il s’agisse de capacité réservée, d’accès pour la recherche et les entreprises, d’efficacité énergétique ou de réversibilité. La souveraineté ne se mesure pas au siège social. Elle se mesure à la capacité de choisir, d’auditer et de remplacer les composants de la pile.
Ce que les décideurs doivent retenir : router plutôt que choisir
La baisse des prix ne justifie pas de changer de modèle chaque semaine. Elle justifie de changer d’architecture. Le modèle unique devient une mauvaise abstraction : une organisation n’a pas un besoin d’IA homogène, elle a des charges de travail différentes, chacune avec son propre compromis.
| Charge de travail | Priorité | Modèle possible | Contrôle nécessaire |
|---|---|---|---|
| Classement ou extraction en volume | coût, vitesse, stabilité | petit modèle ou modèle en poids ouverts | échantillonnage des erreurs, seuil de confiance |
| Rédaction et synthèse internes | qualité, confidentialité | modèle hébergé ou API contractuellement cadrée | sources, journalisation, validation humaine |
| Raisonnement complexe ponctuel | exactitude, capacité | modèle de frontière | comparaison, budget plafonné, vérification |
| Agent qui agit dans un outil métier | fiabilité, permissions, traçabilité | modèle choisi selon l’étape | droits minimaux, confirmation, annulation |
| Agent persistant ou partagé | mémoire, séparation des contextes | architecture dédiée | consentement, isolation, effacement, audit |
Trois conséquences pratiques en découlent.
Mesurer le coût par résultat accepté, pas le prix facial. Le prix au token et le coût par tâche de benchmark sont des indicateurs d’entrée. Ce qui compte pour une direction financière, c’est le coût d’un résultat validé, reprises humaines comprises. Cela suppose un jeu d’évaluation interne, construit sur vos propres cas d’usage, que vous pouvez rejouer à chaque nouveau modèle.
Rendre la couche d’orchestration remplaçable. En une seule journée, les prix de référence ont bougé de 20 à 50 %. Une architecture liée trop étroitement à un fournisseur transforme chaque baisse concurrente en coût d’opportunité. La réversibilité demande des évaluations reproductibles, des formats portables, un suivi des performances et des clauses contractuelles de sortie.
Traiter l’agent comme une nouvelle surface d’exposition. Un modèle consulté ponctuellement reçoit une requête. Un agent persistant observe du contexte, conserve une mémoire, appelle des outils et agit. La sécurité ne porte donc plus seulement sur la donnée envoyée au modèle : elle couvre les permissions, la durée de mémoire, l’identité de l’utilisateur, la chaîne d’outils, les confirmations, les journaux et le retour arrière. Le principe tient en une ligne : plus l’agent est autonome, plus ses droits doivent être précis.
Les limites de cette veille IA
La plupart des chiffres de performance, de coût et d’adoption sont déclarés par les éditeurs eux-mêmes. L’Intelligence Index d’Artificial Analysis est une référence utile, mais une seule, sensible à la version de l’index et au niveau d’effort retenu pour chaque modèle. La répartition des revenus citée par Mozilla date de 2025. Les accusations de distillation et l’enquête chinoise ne sont pas tranchées. Enfin, aucun des agents lancés cette semaine ne dispose encore de données d’usage publiques : on mesure des intentions et des infrastructures, pas complètement une adoption… je préfère être précis sur ce sujet !
Conclusion : écrire les règles avant que les agents ne s’installent
La guerre des prix va accélérer les expérimentations, et c’est une bonne nouvelle : le coût d’apprentissage baisse et il devient possible de comparer davantage de solutions. Elle peut aussi encourager l’empilement d’agents parce qu’ils semblent bon marché. Le coût unitaire baisse ; le coût de coordination, de supervision et d’erreur, lui, ne disparaît pas.
La bonne décision consiste à construire une culture d’organisation capable d’évaluer, de router et de gouverner plusieurs modèles. Concrètement, trois chantiers peuvent démarrer dès maintenant : une grille de routage par charge de travail, un jeu d’évaluation interne rejouable, et une politique de droits pour les agents. Le calcul devient plus accessible au moment précis où l’agent acquiert une mémoire, une présence et un pouvoir d’action. C’est maintenant qu’il faut en fixer les règles.
Sources principales
- OpenAI, GPT-6 Sol et Luna, 22 septembre 2026, via VentureBeat
- Anthropic, Claude Opus 5.5 et grille tarifaire, 22 septembre 2026
- xAI, Grok 4.7, 21 septembre 2026, via The Decoder
- Artificial Analysis, fiche Step 5 Preview
- Xiaomi, MiMo-V2.6-Pro, 22 septembre 2026, via VentureBeat
- Mozilla, State of Open Source AI v1.1, 15 septembre 2026
- Meta, annonces de Connect 2026, 23 septembre 2026
- Google, CC pour les familles, 17 septembre 2026
- Alibaba, Qwen Intelligence, 22 septembre 2026, via Yicai Global
- Ant Group, unité commerce agentique, via Forkast
- Amazon, Seller Assistant et plugin Selling Partner, 23 septembre 2026, via GeekWire
- Dario Amodei, We Must Pace the Frontier, 12 septembre 2026
- Anthropic, indice d’automatisation de la R&D, 17 septembre 2026, via Quartz
- Anthropic, Claude discovers a novel enzyme system, 23 septembre 2026
- Akamai, communiqué sur l’accord avec Anthropic et dépôt 8-K, 24 septembre 2026
- Oracle, force majeure sur Project Jupiter, 24 septembre 2026, via TechCrunch
- Bureau du gouverneur du Texas, suspension des permis, 21 septembre 2026
- Google DeepMind, Gemini 4, 23 septembre 2026, via InfoWorld
- Enquête chinoise sur DeepSeek et Moonshot, via MLex et Decrypt
- Alibaba T-Head, Zhenwu V900, via TechNode
- Huawei, feuille de route Ascend 960 et Peerium, via Tom’s Hardware
- Hausse des prix des puces chinoises, Reuters via Yahoo Finance, 10 septembre 2026
- ESA, lettre d’intention avec Mistral, 23 septembre 2026
- Mistral AI, rachat de Pimento, via Maddyness
Pourquoi les prix des modèles d’IA ont-ils baissé en septembre 2026 ?
Le 22 septembre 2026, OpenAI a divisé par deux les tarifs de GPT-6 Sol et Luna, et Anthropic a réduit de 20 % le prix affiché de Claude Opus 5.5, avec un cache 60 % moins cher. Les éditeurs invoquent des gains d’inférence et de cache. La concurrence chinoise, comme MiMo-V2.6-Pro de Xiaomi à environ 0,13 dollar par tâche, accentue la pression.
Quelle différence entre le prix par token et le coût par tâche ?
Le prix par million de tokens indique le coût d’une unité de texte traitée. Le coût par tâche, mesuré par Artificial Analysis, indique le coût d’un exercice complet, verbosité comprise : un modèle bon marché au token peut coûter plus cher à la tâche s’il produit beaucoup de texte. Aucun des deux ne mesure le coût d’un résultat validé en entreprise, reprises humaines comprises.
Qu’est-ce qu’un agent IA persistant, et en quoi diffère-t-il d’un chatbot ?
Un chatbot répond ponctuellement à une question. Un agent persistant fonctionne en continu : il conserve une mémoire, relit son contexte, appelle des outils et agit, par exemple pour modifier un prix, remplir un formulaire ou préparer un achat. Meta, Google, Alibaba, Ant Group et Amazon ont présenté ce type d’agents cette semaine, sans données d’adoption publiques à ce stade.
Comment une entreprise doit-elle choisir ses modèles d’IA après ces annonces ?
Plutôt que de choisir un modèle unique, il faut router chaque charge de travail vers le modèle adapté : un petit modèle ou un modèle en poids ouverts pour l’extraction en volume, un modèle de frontière pour le raisonnement complexe. Trois chantiers s’imposent : mesurer le coût par résultat accepté, garder une orchestration remplaçable et limiter précisément les droits des agents.