 par
Aucun outil ne peut prouver qu’un texte a été écrit par une intelligence artificielle. Je le dis depuis 2023 : AUCUN outil ne peut PROUVER qu’un texte est produit par une IA. Cette phrase peut sembler provocatrice au moment où un roman en lice pour le Goncourt est mis en cause sur la foi de captures d’écran d’un détecteur, et où des rédactions entières ont répliqué le test. On peut la reformuler en : Thélyson Orélien et l’IA : peut-on prouver qu’un texte est écrit par une IA ? Elle est pourtant la conclusion commune des mathématiciens qui ont étudié la question, des concepteurs des meilleurs détecteurs, et des chercheurs qui les ont évalués de manière indépendante.
La confusion vient de ce que le mot « détecteur » recouvre des objets très différents. Certains mesurent la prévisibilité d’un texte, d’autres apprennent à distinguer deux corpus, d’autres encore cherchent une signature déposée par le générateur. Ces objets n’ont ni les mêmes forces, ni les mêmes angles morts, ni le même rapport à l’idée de preuve. Ils ont en commun de produire un score, et ce score est presque toujours mal lu.
Cet article explique ce que ces outils calculent réellement, pourquoi leur résultat ne peut pas constituer une preuve, comment lire leurs taux d’erreur, et pourquoi le simple choix du passage soumis peut changer le verdict. Il décrit ensuite un phénomène plus lent mais plus profond : les tics d’écriture des modèles se répandent dans l’écriture humaine, et la suspicion d’IA devient le réflexe par défaut face à tout texte un peu lisse. Les sources sont indiquées au fil du texte et rassemblées à la fin.
Au sommaire
Deux familles de détecteurs, et une troisième voie
Un détecteur par mesure statistique et un détecteur par classifieur ne répondent pas à la même question. Le premier demande « ce texte est-il prévisible pour un modèle de langage ? », le second demande « ce texte ressemble-t-il davantage à mon corpus d’IA qu’à mon corpus humain ? ». La différence explique l’essentiel de leurs comportements respectifs.
La mesure statistique (méthodes dites « zero-shot »)
Ces méthodes n’apprennent rien sur les textes d’IA. Elles prennent un modèle de langage de référence, lui font lire le texte, et mesurent à quel point chaque mot était attendu par ce modèle. La grandeur centrale est la perplexité : un texte que le modèle prédit facilement a une perplexité basse. Un modèle de langage produit, par construction, des suites de mots probables ; un humain choisit plus souvent des mots improbables. La deuxième grandeur est la variation de cette prévisibilité d’une phrase à l’autre, popularisée sous le nom de burstiness par GPTZero à ses débuts : l’écriture humaine alterne phrases simples et phrases surprenantes, l’IA est plus régulière.
Des variantes plus sophistiquées existent. DetectGPT (Mitchell et al., 2023) mesure la courbure de la probabilité autour du texte : si de petites reformulations font systématiquement baisser la probabilité, le texte est sans doute un maximum local, donc généré. Binoculars (Hans et al., 2024) compare les perplexités calculées par deux modèles proches, ce qui neutralise en partie l’effet du sujet.
Les limites sont structurelles. Le résultat dépend du modèle de référence, qui n’est jamais celui qui a écrit le texte. Un texte humain très présent dans les données d’entraînement, comme la Déclaration d’indépendance américaine, obtient une perplexité minuscule et passe pour de l’IA. Une écriture normée, un résumé scolaire appliqué, un texte administratif sont naturellement prévisibles. Et la prévisibilité est une propriété fragile : Krishna et al. (2023) ont montré qu’une simple paraphrase automatique faisait chuter le taux de détection de DetectGPT de 70,3 % à 4,6 % à 1 % de faux positifs. Le rapport technique de Pangram note lui-même que les méthodes fondées sur la perplexité échouent sur des documents humains présents dans les données d’entraînement des LLM.
Le classifieur entraîné
Un classifieur ne mesure pas la prévisibilité. On lui montre des milliers ou des millions de textes étiquetés « humain » et « IA », et il apprend une frontière entre les deux. Le premier détecteur d’OpenAI, en 2023, était un modèle RoBERTa entraîné de cette façon ; retiré en juillet 2023, il ne reconnaissait que 26 % des textes d’IA et accusait à tort 9 % des textes humains.
Les classifieurs récents sont bien plus performants, et la raison tient à la construction des données. Pangram, aujourd’hui le mieux évalué, ne dispose d’aucun corpus naturel de textes d’IA. Il associe à chaque texte humain un « miroir synthétique » : on demande à un LLM le sujet du document, puis on lui demande d’écrire un document sur ce sujet, de même longueur (Emi et Spero, 2024). Le modèle apprend ainsi « comment c’est écrit » plutôt que « de quoi ça parle ».
Le second ingrédient est la chasse aux faux positifs : les textes humains que le modèle classe à tort comme IA sont réinjectés dans l’entraînement, mis en miroir, et le modèle est réentraîné. Pangram 4 repose sur un modèle de langage open-weight de type mixture-of-experts auquel sont greffées des têtes de classification (rapport technique, juillet 2026). Un détecteur de ce type est donc lui-même une IA, entraînée à reconnaître la production d’autres IA.
Les limites sont d’une autre nature. Un classifieur ne connaît que ce qu’on lui a montré : les générateurs, les consignes, les genres, les langues et l’époque de son corpus. Ses paramètres de calibration, qui transforment un score brut en étiquette, sont ajustés sur des données réservées et changent d’une version à l’autre. Il est fermé : personne ne peut auditer ses poids. Et il partage avec la première famille une faiblesse de fond que la section suivante formalise : il mesure une ressemblance, pas une origine.
La troisième voie : le tatouage
Le tatouage (watermarking) agit au moment de la génération. Kirchenbauer et al. (2023) ont proposé de partager le vocabulaire, à chaque mot, en une liste « verte » et une liste « rouge » au moyen d’une clé secrète, et de favoriser légèrement les mots verts. Le lecteur ne voit rien ; le détenteur de la clé peut compter les mots verts et obtenir un test statistique avec une probabilité d’erreur calculable. Google DeepMind a déployé ce principe dans Gemini sous le nom de SynthID Text, publié dans Nature en octobre 2024. Anthropic a aussi déployé plus récemment le watermarking.
C’est la seule approche qui produise quelque chose qui ressemble à une preuve. Mais elle suppose la coopération du fournisseur, ne couvre pas les modèles ouverts exécutés localement, s’efface en grande partie à la paraphrase ou à la traduction, et chaque fournisseur détient sa propre clé. Son absence ne prouve rien. Pour tous les textes qui circulent aujourd’hui sans tatouage, on en revient aux deux premières familles, et à leurs limites.
Pourquoi aucun détecteur d’IA ne peut prouver l’origine d’un texte ?
La performance maximale de n’importe quel détecteur est bornée par l’écart entre la distribution des textes humains et celle des textes d’IA, et cet écart se referme à mesure que les modèles progressent. C’est le résultat de Sadasivan et al. (2023), qui l’établissent pour tout détecteur possible, y compris ceux qui n’existent pas encore. Si l’on note TV la distance en variation totale entre les deux distributions, l’aire sous la courbe ROC du meilleur détecteur vérifie :
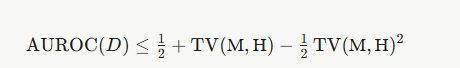
Quand TV tend vers zéro, la borne tend vers 0,5, c’est-à-dire vers le tirage à pile ou face. Le corollaire est brutal : un modèle de langage est entraîné précisément à imiter la distribution humaine, donc chaque progrès des générateurs détruit une partie du signal sur lequel repose tout détecteur. Ce n’est pas une question d’algorithme à trouver, c’est une propriété du problème.
Ce résultat a une nuance importante, apportée par Chakraborty et al. (2023). Tant qu’il subsiste un écart, aussi petit soit-il, la détection redevient possible si l’on dispose d’assez de texte : chaque phrase apporte un minuscule biais statistique, et ces biais s’additionnent. Sur cinquante mots, le signal est noyé dans le bruit ; sur les quarante mille mots d’un roman, une déviation infime devient écrasante. C’est pour cela que tous les détecteurs exigent une longueur minimale (Pangram refuse les textes de moins de 50 mots) et que leurs taux d’erreur s’améliorent avec la longueur.
Mais il faut être précis sur ce que la longueur corrige. Elle réduit l’erreur aléatoire, pas l’erreur systématique. Si un auteur écrit, pour des raisons qui lui sont propres, dans une direction que le détecteur associe à l’IA, chaque page supplémentaire renforce la conviction du modèle dans le mauvais sens. Un texte long rend un détecteur plus sûr de lui, il ne le rend pas plus juste face à un biais corrélé à l’auteur, au genre ou à la chaîne éditoriale. Or de tels biais existent : les concepteurs de Pangram écrivent eux-mêmes que leur modèle ne tient pas compte des personnes qui écrivent volontairement comme des LLM ou qui en ont absorbé le style.
Il y a enfin une raison plus élémentaire. Un détecteur reçoit un texte, c’est-à-dire un point dans un espace ; il ne reçoit pas le processus qui l’a produit. Or la question posée (« qui a écrit ceci, et comment ? ») porte sur le processus. Le même texte final peut résulter d’une génération intégrale, d’un brouillon humain lourdement réécrit par un assistant, d’une traduction retravaillée, ou d’un auteur qui a lu tellement de textes d’IA qu’il en reproduit les cadences.
Au mieux, un détecteur fournit un rapport de vraisemblance : « ce texte est plus probable sous ma distribution IA que sous ma distribution humaine ». Transformer ce rapport en conclusion sur l’auteur exige des informations que le texte ne contient pas : des brouillons, des versions datées, un tatouage, un témoignage. La preuve, quand elle existe, vient de la provenance, jamais de l’analyse du produit fini.
Pangram et le piège du taux de faux positifs
Le pourcentage qu’affiche un détecteur n’est pas la probabilité que le texte ait été écrit par une IA. C’est l’erreur de lecture la plus répandue, et elle se joue à trois niveaux.
Ce que le chiffre mesure vraiment
Chaque outil affiche une grandeur différente. Chez Pangram 4, le pourcentage est la fraction des caractères du document qui ont reçu l’étiquette « IA » après un traitement en plusieurs étapes : prédiction par token, vote majoritaire par phrase, fusion des segments trop courts dans leurs voisins. La « confiance » affichée à côté mesure la netteté de la distribution interne du modèle avant ces votes ; le rapport technique précise qu’elle n’est pas une probabilité recalibrée que l’étiquette finale soit correcte. « 100 % IA, confiance élevée » signifie donc « toutes les phrases ont été étiquetées IA et le modèle n’hésitait pas », et non « il y a 100 % de chances que ce soit de l’IA ».
Les étiquettes elles-mêmes cachent des seuils. Pour ses évaluations, Pangram déclare un document humain si la fraction humaine atteint 90 %, IA si la fraction IA atteint 80 %, mixte sinon. Le score continu est ainsi transformé en verdict binaire, et le curseur qui sépare les deux est un choix de l’éditeur du logiciel, modifiable à chaque version.
Le taux de base
Supposons un détecteur honorable : il repère 90 % des textes d’IA et n’accuse à tort que 2 % des textes humains. Un enseignant corrige 1 000 copies dont 100 ont été rédigées par IA. Le détecteur signale 90 vraies copies d’IA, mais aussi 18 copies humaines sur les 900 restantes. Sur les 108 copies signalées, une sur six est innocente, et rien ne permet de savoir lesquelles. Plus la triche est rare dans la population testée, plus la proportion d’innocents parmi les signalés augmente. Un taux de faux positifs n’a de sens que rapporté au taux de base de ce que l’on cherche.
Sur quelle population le taux a été mesuré
C’est le niveau le plus important, et le moins discuté. Un taux de faux positifs est une mesure sur un corpus donné, et il ne se transporte pas automatiquement à un autre corpus. Pangram 4 annonce 0,0041 % de faux positifs, soit un pour 24 300 environ, mesuré sur plus d’un million de textes anglais ; pour le français, 0,0026 %, soit un pour 38 000.
Ces chiffres sont réels. Mais les faux positifs multilingues sont mesurés sur des sous-ensembles du corpus web FineWeb2 antérieurs à 2022, c’est-à-dire sur du texte humain écrit avant ChatGPT, dans des registres web ordinaires. Le taux qui compte pour un roman de 2026, passé par une chaîne éditoriale où les outils d’IA sont désormais courants, n’a été mesuré par… personne !
Les évaluations indépendantes confirment la performance et illustrent la dépendance au corpus. L’étude de l’université de Chicago (Jabarian et Imas, 2025) conclut, sur 1 992 textes humains d’avant 2020 et autant de textes d’IA, que Pangram est le seul outil à respecter un plafond strict de faux positifs sans sacrifier la détection. Celle de la Vrije Universiteit Brussel (Van Vlasselaer et al., 2026) le place en tête de quatre outils sur des travaux académiques.
Mais une équipe de Notre Dame, sur des résumés scientifiques légèrement retouchés par IA, mesure des signalements par Pangram dans 64 à 80 % des cas, là où Pangram annonce 0,01 % sur son propre jeu de textes polis. Le même outil, testé par deux équipes sur deux corpus, donne des conclusions opposées. Le taux affiché est une propriété du couple outil-corpus, jamais de l’outil seul.
Les faux positifs
Un faux positif est un texte humain déclaré IA, et c’est l’erreur qui détruit des réputations. Elle ne frappe pas au hasard : elle se concentre sur des populations identifiables, et elle est amplifiée par l’échelle à laquelle les outils sont utilisés.
Qui est touché
Les non-natifs, d’abord. Liang et al. (2023, Patterns) ont soumis des rédactions du TOEFL écrites par des étudiants non anglophones à sept détecteurs : en moyenne 61,3 % d’entre elles ont été classées IA, contre presque aucune rédaction d’élèves américains. Un vocabulaire plus restreint et une syntaxe plus régulière rendent un texte plus prévisible, et la prévisibilité est exactement ce que mesurent les méthodes statistiques. Pangram affirme avoir corrigé ce biais, avec un seul faux positif sur 24 586 textes d’apprenants ; mais le même rapport révèle que, lors d’une expérience d’entraînement, les défaillances se sont concentrées dans deux registres précis, l’écriture académique et les essais d’apprenants de l’anglais. La fragilité n’a pas disparu, elle a été contenue.
L’écriture normée, ensuite. Un rapport technique, un texte réglementaire, un résumé scolaire bien appliqué, une notice, tout ce qui obéit à un format obtient une perplexité basse. Des détecteurs ont signalé la Constitution américaine et des passages de la Bible comme générés, non parce qu’ils ressemblent à ChatGPT, mais parce que les modèles de référence les ont mémorisés.
Enfin, une catégorie nouvelle et mal mesurée : les humains dont le style a été façonné par la fréquentation des IA, et les textes passés par des outils d’aide à l’écriture. On y reviendra plus bas ; retenons que Pangram exclut explicitement ce cas de son périmètre.
L’effet d’échelle
Un taux de faux positifs de 1 % paraît faible. Appliqué aux millions de devoirs soumis chaque année aux plateformes d’intégrité académique, il produit des dizaines de milliers d’accusations infondées. Turnitin annonçait moins de 1 % de faux positifs au niveau du document lors du lancement de sa fonction en 2023 ; l’université Vanderbilt a désactivé cette fonction la même année, en invoquant précisément ce calcul et l’impossibilité pour un étudiant de prouver qu’il n’a pas utilisé d’IA. Weber-Wulff et al. (2023), dans la plus vaste évaluation académique de l’époque, concluaient qu’aucun des quatorze outils testés n’atteignait 80 % de précision et qu’aucun n’était fiable pour un usage disciplinaire.
L’asymétrie des conséquences
Un faux positif coûte à la personne accusée bien plus qu’un faux négatif ne coûte à l’institution. La personne accusée doit prouver un fait négatif, ce qui est impossible à partir du texte seul. Les meilleurs outils ont tiré la leçon en réglant leur curseur pour minimiser les faux positifs, au prix des faux négatifs. C’est un choix raisonnable, mais il a une conséquence que la section suivante détaille : un verdict « humain » de ces outils ne vaut à peu près rien.
Les faux négatifs, qui ne prouvent rien
Un verdict « écrit par un humain » n’établit pas qu’un texte a été écrit par un humain. Il établit seulement que le détecteur n’a pas trouvé ce qu’il cherche, et il existe au moins quatre façons documentées de le lui cacher.
La paraphrase est la plus ancienne. Krishna et al. (2023) ont entraîné un modèle de reformulation et l’ont appliqué à des textes d’IA : la détection de DetectGPT est tombée de 70,3 % à 4,6 %, et les tatouages ont été fortement dégradés. Sadasivan et al. ont montré qu’une paraphrase récursive légère suffisait à casser la quasi-totalité des détecteurs sans dégrader la qualité du texte. Perkins et al. (2024) ont obtenu des résultats comparables avec des techniques triviales, accessibles à n’importe quel étudiant.
Les « humaniseurs » industrialisent ce contournement. Ce sont des services commerciaux, ou de simples jeux d’instructions, qui injectent des fautes, changent la casse, substituent des synonymes ou reformulent dans un style plus irrégulier. Pangram consacre une tête de classification à leur détection et revendique de repérer les textes humanisés comme IA dans 97,7 % des cas sur treize services commerciaux. Mais le rapport précise que ce classifieur n’est appliqué que lorsque le détecteur principal a déjà trouvé des indices d’IA. Si l’humanisation réussit à faire basculer le score principal vers « humain », le garde-fou ne s’exécute jamais. L’équipe de Notre Dame observe d’ailleurs que plus de 96 % des réécritures humanisées échappent à Pangram et à GPTZero sur son corpus.
Les attaques par optimisation directe sont les plus puissantes. Elles utilisent le détecteur comme oracle : on génère un texte, on lit le score, on modifie, on recommence. StealthRL (UCSD, 2026) atteint ainsi 99,9 % d’évasion par apprentissage par renforcement.
En septembre 2026, l’ingénieur Anis Ayari a montré publiquement qu’un simple algorithme génétique, avec Pangram comme fonction d’évaluation, produisait en six heures un article entièrement généré que Pangram 4 classait « 100 % humain ». Ce résultat n’a rien de surprenant pour qui connaît la littérature ; il contredit seulement l’idée, entretenue par la communication des éditeurs, que le contournement serait difficile. La contrepartie est que de telles recettes ont une durée de vie courte : dès qu’elles circulent, elles deviennent des données d’entraînement pour la version suivante.
Enfin, il y a l’asymétrie voulue. Un détecteur réglé pour presque jamais accuser à tort laisse passer davantage de textes d’IA ; c’est mécanique. Un internaute a fait remarquer qu’en changeant quelques mots d’un paragraphe du roman d’Orélien, Pangram le déclarait 100 % humain. La chercheuse Marzena Karpinska a répondu que cela ne la surprenait pas : c’est ainsi que l’on humanise un texte, et Pangram est plus facile à tromper de cette façon parce qu’il est optimisé pour un taux minime de faux positifs.
La conséquence pratique est simple. Quand une rédaction rassure en indiquant que les autres finalistes d’un prix sont « 100 % humain », elle ne prouve rien sur ces autres finalistes. Et quand un auteur brandit un verdict « humain » d’un autre outil pour se défendre, il ne prouve rien non plus. Le faux négatif est facile à fabriquer, donc le négatif n’a pas de valeur probante ; le faux positif est rare mais impossible à réfuter depuis le texte, donc le positif est un indice fort mais pas une preuve.
Le problème de la fenêtre de test
Un détecteur ne lit jamais le livre ; il lit des fenêtres, et la façon dont on découpe le texte change le verdict. Ce point est rarement expliqué, alors qu’il conditionne toute lecture de capture d’écran.
Comment le texte est réellement lu
Le modèle de Pangram 4 a un contexte de 512 tokens, soit environ 350 à 400 mots de français. Un document plus long est découpé en fenêtres chevauchantes de 512 tokens avec un pas de 256, chaque token étant vu par deux fenêtres, puis les prédictions sont recombinées par un décodage global. GPTZero procède différemment, en faisant tourner un classifieur phrase par phrase. Dans les deux cas, l’unité d’analyse n’est pas le document mais le fragment, et le score de document est une agrégation.
Cette agrégation est ensuite lissée. Chez Pangram, le décodage pénalise les changements d’étiquette entre tokens voisins, chaque phrase reçoit l’étiquette majoritaire de ses tokens, et les plages d’étiquettes plus courtes qu’un minimum configurable sont fusionnées avec leurs voisines. Le résultat est fait pour produire des blocs homogènes. Un passage affiché « 100 % IA » d’un seul tenant est donc en partie un artefact de conception : le système est construit pour trancher par plages, pas pour nuancer phrase à phrase. C’est aussi ce qui explique que les scores évoluent par paliers quand on modifie un texte, une phrase qui bascule faisant sauter tout un segment.
L’endroit du découpage
Le rapport technique de Pangram le reconnaît noir sur blanc : les prédictions pour un même texte dans des contextes différents peuvent être incohérentes, et une section d’un article analysée isolément peut recevoir une prédiction différente de celle qu’elle reçoit au sein du document complet. Les concepteurs ajoutent qu’ils travaillent à réduire ces incohérences.
On peut raisonnablement penser que l’endroit précis où l’on coupe influe sur le résultat, pour trois raisons. Un extrait qui commence au milieu d’un paragraphe prive les premières fenêtres de leur contexte ; un extrait court n’est vu que par une ou deux fenêtres, ce qui supprime l’effet de moyenne ; et la règle de fusion des segments courts fait que l’étiquette d’une phrase dépend de ses voisines, donc de ce qu’on a inclus ou exclu. Le rapport montre d’ailleurs que les taux d’erreur diminuent régulièrement quand la longueur passe de 50 à 500 mots. Deux personnes qui soumettent le même chapitre en le découpant différemment peuvent obtenir des pourcentages différents, sans que l’une ou l’autre ait triché.
Ce que le texte a subi avant d’arriver
Un dernier facteur est presque jamais documenté : la forme sous laquelle le texte arrive au détecteur. Un roman copié depuis un fichier EPUB, extrait d’un PDF, passé par une reconnaissance optique ou retapé n’a pas les mêmes apostrophes, les mêmes guillemets, les mêmes espaces insécables ni les mêmes tirets.
Le français est saturé d’apostrophes, et l’apostrophe typographique d’un livre composé n’est ni l’apostrophe droite d’un traitement de texte ni celle d’une sortie de chatbot. Pangram indique que les artefacts accidentels (extraction PDF, copier-coller, OCR, normalisation Unicode) ne sont pas classés comme humanisation par son garde-fou ; rien n’est dit de leur effet sur le détecteur principal, et la démonstration d’Ayari, qui identifie l’apostrophe comme un levier efficace pour faire basculer le score, suggère que cet effet n’est pas nul.
La conséquence méthodologique est claire. Un résultat de détecteur devrait toujours être accompagné du texte exact soumis, de sa provenance, de la version de l’outil et de la date. Un test sérieux soumet le document entier, puis plusieurs découpages, et rapporte la variance. Une capture d’écran d’un paragraphe isolé ne satisfait aucune de ces conditions.
Les tics de l’IA qu’on retrouve partout
Les modèles de langage ont un style par défaut, reconnaissable et mesuré, mais ce style est un indice de ressemblance, pas une signature d’origine. Il faut d’abord comprendre d’où il vient.
Pourquoi les modèles écrivent tous pareil
Sans consigne particulière, un modèle retombe sur ce que l’alignement par retour humain lui a appris à produire. Les annotateurs ont récompensé les réponses claires, structurées, équilibrées, polies et rassurantes ; le modèle a appris à maximiser ces signaux jusqu’à la caricature. Le résultat est une régression vers un registre moyen, celui du rédacteur web ou du consultant, que les modèles n’ont pas inventé mais concentré. Ce phénomène de resserrement stylistique est documenté sous le nom d’effondrement de mode : les sorties d’un modèle aligné sont moins diverses que celles du modèle de base.
Ce qu’on observe
Les constructions rhétoriques d’abord. L’antithèse corrective (« ce n’est pas X, c’est Y »), le recentrage dramatique (« la vraie question est »), la question suivie de sa réponse immédiate, la règle de trois, la chute sentencieuse en fin de paragraphe, et le participe présent en queue de phrase (« soulignant ainsi l’importance de »). Reinhart et al. (2025, PNAS) ont mesuré que les modèles ajustés par instruction utilisent nettement plus de propositions participiales et de nominalisations que les humains, sur des corpus contrôlés.
Le vocabulaire ensuite. Kobak et al. (2024) ont analysé plus de quatorze millions de résumés PubMed et observé l’explosion soudaine de mots comme delves, underscores, intricate ou showcasing à partir de 2023 ; ils en déduisent qu’au moins 10 % des résumés de 2024 ont été retravaillés par un modèle de langage. En français, les équivalents sont « souligner », « mettre en lumière », « témoigner de », « se pencher sur », « crucial », « incontournable », « marque un tournant », « joue un rôle clé ».
La mise en forme enfin. Titres et listes à puces là où un humain écrirait trois paragraphes, gras systématique, symétrie des sections, tiret cadratin pour les incises, calques de l’anglais et typographie anglaise dans un texte français. La page « Signs of AI writing » de Wikipédia, tenue par les bénévoles du projet de nettoyage, en dresse l’inventaire le plus complet.
Pourquoi ce ne sont pas des preuves
Ces marqueurs ont trois défauts en tant qu’indices d’origine. Ils préexistaient aux modèles : les manuels de rédaction commerciale, les publications LinkedIn et les rapports de conseil les employaient déjà, et c’est précisément parce qu’ils étaient fréquents dans les données d’entraînement que les modèles les ont amplifiés. Ils s’effacent à la première consigne : un utilisateur qui demande « écris sans listes, sans formules toutes faites, avec des phrases irrégulières » en supprime l’essentiel, et les éditeurs de modèles ajustent leur entraînement dès qu’un tic devient un mème public.
Et surtout, ils se répandent chez les humains, ce qui est l’objet de la section suivante. Un texte qui accumule dix de ces marqueurs mérite un regard attentif ; un texte qui en contient trois ressemble simplement à ce qu’on écrit en 2026.
La contamination de l’écriture humaine
Dans cette affaire, il ne faut pas non plus oublier que les humains se mettent à écrire, et même à parler, comme les modèles, ce qui referme par l’autre côté l’écart sur lequel reposent les détecteurs. Ce mouvement est mesuré, et il est reconnu par les concepteurs d’outils eux-mêmes.
La mesure la plus frappante porte sur l’oral. Une équipe de l’Institut Max Planck pour le développement humain (Yakura et al., 2024) a analysé plusieurs centaines de milliers de vidéos de conférences, de podcasts et de cours universitaires. Dans les dix-huit mois qui ont suivi la sortie de ChatGPT, la fréquence des mots typiques du modèle, delve, meticulous, realm, comprehend, a augmenté dans la parole spontanée des locuteurs anglophones, avec une courbe qui suit celle de l’adoption de l’outil. Ce n’est pas du texte généré, ce sont des personnes qui ont lu assez de sorties de modèles pour en adopter le lexique.
Le mécanisme est ordinaire. On apprend à écrire par imitation de ce qu’on lit, et une part croissante de ce qu’on lit est produite ou retouchée par des modèles. Un étudiant qui interroge un assistant tous les jours intériorise ses cadences. Un journaliste dont les dépêches passent par un outil de réécriture voit son propre style dériver.
Un auteur qui utilise un correcteur intégré à son traitement de texte reçoit, à chaque suggestion acceptée, une leçon de style dans la direction du modèle. Les outils éditoriaux ont d’ailleurs rendu la frontière poreuse : Pangram classe comme « humain » un texte ayant subi une relecture légère ou une traduction littérale, comme « assisté » un texte réécrit en profondeur, et l’écart entre les deux dépend d’un seuil interne.
Les détecteurs le savent. Le rapport de Pangram 4 formule la limite sans détour : le modèle ne tient pas compte des personnes qui écrivent volontairement comme des LLM ou qui ont absorbé des éléments de leur style, et cette dérive des données est un axe majeur de ses recherches. La formulation mérite d’être lue lentement. Le taux de faux positifs de un pour 38 000 en français a été mesuré sur du texte humain d’avant 2022, c’est-à-dire sur une population qui n’existe plus tout à fait. Un détecteur entraîné à repérer l’écart entre deux distributions mesure un écart que les deux côtés sont en train de combler.
Il y a une boucle de rétroaction supplémentaire, propre à la suspicion elle-même. Dès qu’un tic devient un signal public d’IA, les humains qui l’employaient l’abandonnent : on supprime ses tirets cadratins, on évite « souligner », on réintroduit des fautes. La distribution humaine se déplace alors dans l’autre sens, non par contamination mais par évitement. Les détecteurs, entraînés sur un instantané, courent après une cible qui bouge dans les deux directions à la fois. La borne de Sadasivan ne dit pas seulement que les générateurs se rapprochent des humains ; elle s’applique aussi quand les humains se rapprochent des générateurs.
L’affaire Thélyson Orélien et la suspicion généralisée
Ce que je constate c’est aussi que la présomption s’est inversée : face à un texte propre, structuré et sans faute, le réflexe est désormais de supposer qu’une machine l’a écrit. Ce renversement a des causes mesurables et des coûts qui ne le sont pas encore.
Les causes sont d’abord quantitatives. Pangram estime qu’une part importante des nouveaux contenus en ligne est largement ou entièrement générée, et cite dans son rapport des travaux évaluant à plus d’un tiers la proportion de nouveaux contenus internet, à 26 % celle des publications longues sur les réseaux sociaux et à 9 % celle des articles de presse. Quand un lecteur sait qu’un texte sur trois ou quatre est produit par une machine, il ajuste sa probabilité a priori, et il a raison de le faire au niveau statistique. Le problème est qu’il l’applique ensuite à chaque texte individuel comme s’il s’agissait d’une certitude.
La suspicion a un coût documenté pour les auteurs. Raj, Berg et Seamans (2026, Journal of Experimental Psychology: General) montrent que les lecteurs dévaluent de façon persistante une œuvre créative dès lors qu’on leur indique qu’une IA y a contribué, même quand le texte est identique. Cette pénalité de divulgation crée une incitation à ne rien déclarer, qui nourrit à son tour la suspicion : puisque personne n’avoue, tout le monde est suspect.
Elle a aussi un coût pour la vérité. L’affaire du roman de Thélyson Orélien en est un cas d’école. Un compte anonyme, créé quelques jours plus tôt, publie des captures d’écran d’un détecteur ; le message atteint trois millions de vues en deux jours ; des rédactions répliquent le test et obtiennent des résultats convergents ; d’autres outils donnent des résultats opposés ; l’auteur et ses éditeurs dénoncent une campagne, et le débat prend une dimension politique et raciale.
À aucun moment la question du processus d’écriture n’est examinée, parce que personne n’y a accès. La capture d’écran a tenu lieu de verdict, et le verdict tient lieu de preuve. La chercheuse de la VUB dont l’étude est invoquée pour défendre l’outil écrit pourtant qu’un score d’IA ne peut servir que de signal invitant à regarder de plus près.
Il y a enfin un coût sur l’écriture elle-même, qui rejoint la section précédente. Des auteurs modifient leur style pour ne pas ressembler à une machine : phrases volontairement bancales, fautes laissées, structures brouillées. Des enseignants apprennent à leurs élèves à éviter les tirets, les listes et le mot « crucial ». L’écriture soignée devient un indice à charge, et la maladresse une preuve d’humanité. C’est une inversion des valeurs de la rédaction que ni les détecteurs ni les modèles n’ont voulue, mais que leur coexistence produit.
La suspicion généralisée est, au fond, le résultat le plus solide de tout ce qui précède. Puisqu’aucune preuve n’est possible depuis le texte seul, la place laissée vide est occupée par la présomption, et la présomption suit le taux de base perçu. Tant que l’on demandera aux détecteurs de trancher, ils trancheront, et le doute se déplacera vers ceux qui écrivent bien.
Ce qu’il reste à faire
Un score de détecteur est un signal à instruire, pas un verdict à publier. Les meilleurs outils sont réellement bons, et un signal fort, répliqué sur un texte long, mérite d’être pris au sérieux. Mais le prendre au sérieux signifie ouvrir une enquête sur le processus, pas clore le débat sur le produit fini.
Pour qui utilise un détecteur, quatre pratiques découlent de ce qui précède. Soumettre le document entier et non un extrait, puis plusieurs découpages, et rapporter la variance. Consigner le texte exact soumis, sa provenance, la version de l’outil et la date, puisque tous ces paramètres changent le résultat. Ne jamais lire un pourcentage comme une probabilité, et exiger de l’éditeur du logiciel le corpus sur lequel son taux de faux positifs a été mesuré. Et traiter un verdict « humain » comme une absence de signal, jamais comme un certificat.
Pour qui doit trancher, les preuves de processus sont les seules qui vaillent : historiques de versions, brouillons datés, échanges éditoriaux, capacité de l’auteur à rendre compte de ses choix, bibliographies vérifiables. Elles ne sont pas infaillibles, mais elles sont contestables et vérifiables, ce qu’un score de boîte noire n’est pas. Jabarian et Imas proposent un cadre utile pour les institutions : fixer d’abord un plafond de faux positifs tolérable, puis n’accepter que les outils qui le respectent, et n’en faire qu’un déclencheur d’examen.
Pour qui écrit, la seule protection durable est la trace. Écrire dans des outils qui conservent l’historique, dater ses brouillons, garder ses notes. C’est une contrainte nouvelle et injuste, imposée par une technologie que l’auteur n’a pas choisie. Mais tant que la preuve restera impossible depuis le texte, la provenance restera le seul rempart contre la présomption…
Références
Théorie de la détection
- Sadasivan, Kumar, Balasubramanian, Wang, Feizi (2023). Can AI-Generated Text be Reliably Detected? arXiv:2303.11156
- Chakraborty, Bedi, Zhu, An, Manocha, Huang (2023). On the Possibilities of AI-Generated Text Detection. arXiv:2304.04736
- Krishna, Song, Karpinska, Wieting, Iyyer (2023). Paraphrasing evades detectors of AI-generated text, but retrieval is an effective defense. arXiv:2303.13408
Méthodes statistiques et classifieurs
- Mitchell, Lee, Khazatsky, Manning, Finn (2023). DetectGPT: Zero-Shot Machine-Generated Text Detection using Probability Curvature. arXiv:2301.11305
- Hans et al. (2024). Spotting LLMs with Binoculars: Zero-Shot Detection of Machine-Generated Text. arXiv:2401.12070
- Emi, Spero (2024). Technical Report on the Pangram AI-Generated Text Classifier. arXiv:2402.14873
- Glickenhaus, Thai, Russell, Masrour, Han, Spero, Emi (2026). Pangram 4 Technical Report. arXiv:2607.27183
Tatouage
- Kirchenbauer, Geiping, Wen, Katz, Miers, Goldstein (2023). A Watermark for Large Language Models. arXiv:2301.10226
- Dathathri et al. (2024). Scalable watermarking for identifying large language model outputs. Nature, 634. Article
Évaluations indépendantes et faux positifs
- Jabarian, Imas (2025). Artificial Writing and Automated Detection. NBER Working Paper 34223. NBER
- Van Vlasselaer, Van Droogenbroeck, Spruyt (2026). Who wrote this? Evaluating the reliability of AI detection tools in higher education. International Journal for Educational Integrity, 22:16. Springer
- Notre Dame (2026). Why AI Detection Fails for Academic Integrity. arXiv:2608.11256
- Liang, Yuksekgonul, Mao, Wu, Zou (2023). GPT detectors are biased against non-native English writers. Patterns, 4(7). DOI
- Weber-Wulff et al. (2023). Testing of detection tools for AI-generated text. International Journal for Educational Integrity, 19:26. Springer
- Perkins et al. (2024). Simple Techniques to Bypass GenAI Text Detectors. International Journal of Educational Technology in Higher Education, 21:53. DOI
Style des modèles et contamination
- Kobak, González-Márquez, Horvát, Lause (2024). Delving into ChatGPT usage in academic writing through excess vocabulary. arXiv:2406.07016
- Reinhart et al. (2025). Do LLMs write like humans? Variation in grammatical and rhetorical styles. PNAS, 122(8). DOI
- Yakura, Lopez-Lopez, Brinkmann, Serna, Gupta, Rahwan (2024). Empirical evidence of Large Language Model’s influence on human spoken communication. arXiv:2409.01754
- Russell, Karpinska, Iyyer (2025). People who frequently use ChatGPT for writing tasks are accurate and robust detectors of AI-generated text. ACL 2025. arXiv:2501.15654
- Wikipédia, WikiProject AI Cleanup. Signs of AI writing. Page
Suspicion et perception
- Raj, Berg, Seamans (2026). The artificial intelligence disclosure penalty: Humans persistently devalue AI-generated creative writing. Journal of Experimental Psychology: General, 155(4). DOI
Affaire Orélien et démonstrations publiques
- Radio-Canada (23 septembre 2026). Controverse Thélyson Orélien : ce qu’il faut savoir sur Pangram. Article
- Le Devoir (23 septembre 2026). Thélyson Orélien accusé sur X d’avoir généré son roman par IA. Article
- Franceinfo (23 septembre 2026). Vrai ou faux : l’écrivain Thélyson Orélien a-t-il utilisé l’IA ? Article
- Anis Ayari, Defend Intelligence (septembre 2026). Fil X sur le contournement de Pangram par algorithme génétique. Compte
Le roman de Thélyson Orélien a-t-il été écrit par une IA ?
Personne ne peut l’établir à partir du texte seul. Le détecteur Pangram classe plus de 94 % de C’était ça ou mourir comme généré, un résultat répliqué par Le Monde, Radio-Canada et franceinfo, tandis que d’autres outils concluent l’inverse. C’est un indice statistique fort, pas une preuve : seuls des brouillons datés, un historique de versions ou des échanges éditoriaux pourraient trancher.
Comment fonctionne le détecteur Pangram ?
Pangram est un modèle de langage réentraîné à distinguer des millions de textes humains de leurs « miroirs » générés par une vingtaine d’IA. Il lit le texte par fenêtres de 512 tokens, étiquette chaque phrase, puis lisse le résultat par plages. Le pourcentage affiché est la part du texte étiquetée IA, et non la probabilité que le texte ait été écrit par une IA.
Pangram est-il fiable ? Quel est son taux de faux positifs ?
Pangram annonce un faux positif pour 24 000 textes en anglais et pour 38 000 en français, des chiffres confirmés par des études de Chicago et de la VUB. Mais ces taux sont mesurés sur du texte web d’avant 2022 ; une équipe de Notre Dame trouve 64 à 80 % de signalements sur des textes humains légèrement retouchés. La fiabilité dépend du corpus, du découpage et de la version.
Comment reconnaître un texte écrit par ChatGPT ou une autre IA ?
Certains tics sont fréquents : formules du type « ce n’est pas X, c’est Y », triplets, listes à puces, participes présents, vocabulaire comme « souligner » ou « crucial ». Mais ces marqueurs préexistaient aux modèles, disparaissent à la première consigne et se répandent chez les humains. Seuls les artefacts (« En tant que modèle de langage… », références inventées) approchent une preuve.