Tokens en français : la taxe invisible de 31 % à 58 % face à l’anglais
 par
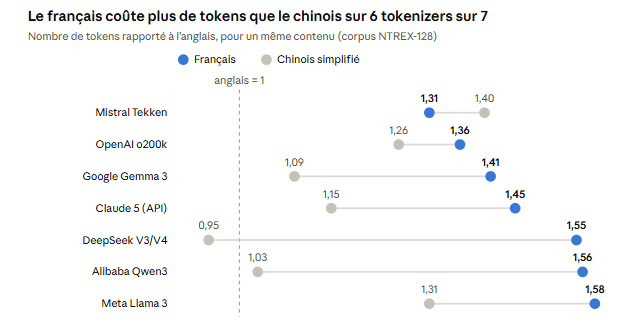
Tokens en français : une IA consomme 31 % à 58 % de tokens de plus qu’en anglais pour un contenu identique. C’est ce que mesure Thomas Serval, professeur affilié à NEOMA Business School, dans un premier papier publié le 30 septembre 2026, « The Invisible Language Tax ». Il y compare sept tokenizers de 2026, puis teste un prototype conçu pour le français et publie aussi les cas où ce prototype perd.
Thomas Serval, cofondateur et PDG du groupe Baracoda, passé par des postes de direction chez Microsoft et Google, il est membre de l’Académie des technologies et détient quelque 80 brevets en IA et technologies connectées. Il a rejoint NEOMA en avril 2025 pour contribuer au NEOMA AI Research Institute.
À NEOMA, la recherche en intelligence artificielle est portée par le NEOMA AI Research Institute, que l’école présente comme son initiative stratégique phare en IA. L’institut rassemble des professeurs, des doctorants et des post-doctorants de plusieurs départements, qui travaillent sur les aspects techniques de l’IA comme sur ses applications. Cette étude vise à regarder les effets induits de la langue dans le traitement IA.
Un token est un fragment de mot. Les grands modèles de langage facturent au token, et leur fenêtre de contexte, c’est-à-dire leur mémoire de travail, se compte dans la même unité. Le découpage est fait par un outil appelé tokenizer, entraîné sur des corpus où l’anglais domine : un même contenu en sort découpé en morceaux plus nombreux dans les autres langues.