par
Tokens en français : une IA consomme 31 % à 58 % de tokens de plus qu’en anglais pour un contenu identique. C’est ce que mesure Thomas Serval, professeur affilié à NEOMA Business School, dans un premier papier publié le 30 septembre 2026, « The Invisible Language Tax ». Il y compare sept tokenizers de 2026, puis teste un prototype conçu pour le français et publie aussi les cas où ce prototype perd.
Thomas Serval, cofondateur et PDG du groupe Baracoda, passé par des postes de direction chez Microsoft et Google, il est membre de l’Académie des technologies et détient quelque 80 brevets en IA et technologies connectées. Il a rejoint NEOMA en avril 2025 pour contribuer au NEOMA AI Research Institute.
À NEOMA, la recherche en intelligence artificielle est portée par le NEOMA AI Research Institute, que l’école présente comme son initiative stratégique phare en IA. L’institut rassemble des professeurs, des doctorants et des post-doctorants de plusieurs départements, qui travaillent sur les aspects techniques de l’IA comme sur ses applications. Cette étude vise à regarder les effets induits de la langue dans le traitement IA.
Un token est un fragment de mot. Les grands modèles de langage facturent au token, et leur fenêtre de contexte, c’est-à-dire leur mémoire de travail, se compte dans la même unité. Le découpage est fait par un outil appelé tokenizer, entraîné sur des corpus où l’anglais domine : un même contenu en sort découpé en morceaux plus nombreux dans les autres langues.
Au sommaire
Tokens en Français : Le français paie 31 % à 58 % de tokens en plus
La mesure porte sur NTREX-128, un corpus de 1 997 phrases de presse en anglais accompagnées de traductions professionnelles. Pour un même texte, le français demande entre 1,31 et 1,58 fois le nombre de tokens de l’anglais.
Sept tokenizers de modèles très utilisés en 2026 sont comparés : OpenAI o200k, Meta Llama 3, Alibaba Qwen3, DeepSeek V3/V4, Google Gemma 3, Mistral Tekken et celui de la génération 5 de Claude. Ce dernier n’est pas public, et l’auteur l’a mesuré phrase par phrase avec l’API de comptage d’Anthropic.
Tekken, le tokenizer de Mistral, est le moins pénalisant avec 31 % de tokens en plus. Celui de Llama 3 est le plus pénalisant, à 58 %, et Claude 5 se situe à 45 %.
Le français reste pourtant bien loti : il se classe entre le 9e et le 24e rang des langues les moins chères, sur 124 traductions non anglaises. La langue médiane paie 1,69 à 2,15 fois le tarif anglais.
Si vous comparez des fournisseurs, comparez les prix par document. Le tokenizer de Claude 5 découpe tous les textes plus finement que les autres (84 000 tokens pour le corpus anglais, contre 52 000 à 54 000 ailleurs), si bien qu’un prix par token ne se compare pas d’un fournisseur à l’autre.
Le chinois s’en sort mieux que le français
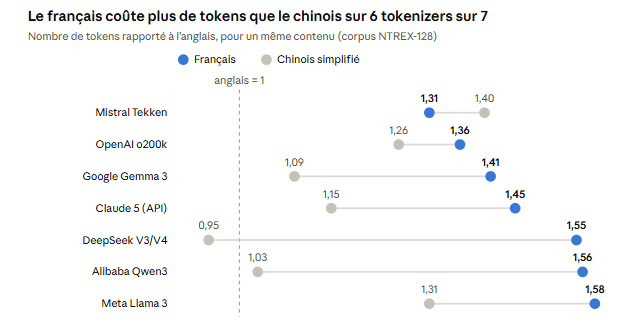
Le chinois simplifié va de 5 % de tokens en moins que l’anglais à 40 % de plus. Il est moins cher que le français sur six des sept tokenizers, et la seule exception est Tekken, celui du français Mistral.
Qwen3 et DeepSeek, les deux tokenizers d’éditeurs chinois, sont ceux qui traitent le mieux le chinois, et celui de Mistral traite le mieux le français. J’y lis un argument concret pour le débat sur la souveraineté : la langue dans laquelle une organisation travaille fait partie des critères de choix d’un modèle, au même titre que le prix affiché.
Langues régionales et d’outre-mer : jusqu’à 3,3 fois l’anglais
Les langues régionales et ultramarines de France paient environ 1,6 à 3,3 fois le nombre de tokens de l’anglais. Comme elles sont absentes de NTREX, la mesure s’appuie ici sur la Déclaration universelle des droits de l’homme, avec six tokenizers.
Le breton et le corse demandent environ le double des tokens de l’anglais, comme le wolof et le bambara dans l’espace francophone. Le picard, le wallon et le tahitien montent entre 2,5 et 3,5 fois.
Rapporté au français, le surcoût va de 20 % pour l’occitan à 45 % pour le breton, 90 % pour le wallon et 130 % pour le tahitien. En tahitien, l’okina se note par une apostrophe, qui hache les mots en petits fragments.
Ces valeurs sont des ordres de grandeur, prévient l’auteur : il n’y a qu’un texte par langue, et la correspondance phrase à phrase n’a pas été vérifiée.
Hors de France, les écritures non latines restent les plus pénalisées. Le tibétain, le divéhi, le khmer et le lao atteignent 10 à 14 fois l’anglais sur les tokenizers les moins adaptés.
D’où vient la surtaxe « Tokens en français »
La surtaxe se décompose en deux facteurs, et un seul dépend du tokenizer. Le premier est la longueur : sur NTREX, les traductions françaises comptent 18 % de caractères de plus que l’original anglais.
Le second est la compression. À nombre de caractères égal, le français consomme de 11 % (Tekken) à 33 % (Llama 3) de tokens en plus. Pour Tekken, 1,18 multiplié par 1,11 donne 1,31.
L’auteur précise que cette décomposition est une identité comptable, sans valeur d’explication causale. Le ratio de longueur a été observé sur de la presse traduite et ne se généralise pas tel quel à d’autres textes.
Avec les agents, l’écart se creuse
Sur une requête courte, la surtaxe est proportionnelle : à prix par token constant, une entrée qui coûte 100 en anglais coûte 131 à 158 en français. En usage long ou agentique, trois mécanismes creusent l’écart en valeur absolue.
- L’historique est renvoyé à chaque tour. Sans cache, le coût cumulé croît comme le carré du nombre de tours, et l’écart absolu avec lui.
- Les tarifs changent de palier. Google facture l’entrée de Gemini 3.1 Pro 2 dollars par million de tokens jusqu’à 200 000 tokens, puis 4 dollars au-delà (tarif relevé par l’auteur le 28 septembre 2026), et un prompt français franchit ce seuil plus tôt.
- La fenêtre de contexte se remplit plus vite. Une fenêtre de 128 000 tokens contient, en français, l’équivalent de 81 000 à 98 000 tokens de contenu anglais, soit 24 % à 37 % de moins.
Le papier simule une boucle d’agent sans cache, qui ajoute 5 000 tokens équivalent anglais par tour, avec la surtaxe de Gemma 3 (1,41). Le prompt français franchit le seuil des 200 000 tokens au tour 29, l’anglais au tour 41, et entre les deux chaque tour français coûte 2,8 fois le tour anglais. Le sujet des tokens en français est donc une vraie problématique.
Le surcoût cumulé passe ainsi de 41 % à 112 %, avant de retomber à 51 % au tour 80. Dans le même scénario, la fenêtre de 128 000 tokens sature au tour 19 en français, contre le tour 26 en anglais.
Un tokenizer pensé pour le français utilise 11,5 % de tokens en moins
Une partie de la surtaxe vient du tokenizer lui-même, c’est-à-dire de ses données d’entraînement. Pour le montrer, l’auteur entraîne des tokenizers identiques en tout point (48 Mo d’Europarl, vocabulaire de 50 000 tokens) et ne fait varier que la part de français.
Passer de 0 % à 25 % de français fait tomber la surtaxe d’environ 1,82 à 1,17. Au-delà, le français ne gagne presque plus rien (2,3 % de tokens en moins entre 25 % et 75 %) et l’anglais se dégrade de 3,8 %. Une part modeste de français capte donc l’essentiel du gain.
L’expérience n’explique pas pourquoi les tokenizers commerciaux font moins bien, précise l’auteur : ils couvrent de nombreuses langues et du code dans un seul vocabulaire, et leurs données d’entraînement ne sont pas publiques.
Le prototype s’appelle Baracoda FR v1.2. C’est un tokenizer BPE au niveau de l’octet, de la même taille de vocabulaire que Tekken (131 072 tokens), entraîné sur 736 Mo de données : 300 Mo de web français, 300 Mo de web anglais, 100 Mo d’Europarl et 36 Mo de code Python.
Le test final porte sur six corpus en français et en anglais, jamais consultés pendant la conception, avec un protocole que l’auteur déclare avoir fixé à l’avance. Le prototype y utilise 11,5 % de tokens de moins que Tekken en français (intervalle de confiance à 95 % : 11,1 % à 11,9 %) et 3,7 % de moins en anglais. Sur du code Python, mesuré à part, il en utilise 2,7 % de moins.
Le résultat tient après retrait des phrases de test présentes dans les données d’entraînement. Sur NTREX, la surtaxe du français descend à 1,20, contre 1,31 pour Tekken.
Ce que l’étude ne démontre pas sur les aspects tokens en français
Ces résultats mesurent le découpage du texte. Ils ne disent rien des factures réelles, de la qualité d’un modèle ou de la réussite d’une tâche, et l’auteur liste lui-même les contreparties de son prototype.
- En espagnol et en allemand, le prototype consomme 30 % à 38 % de tokens de plus que Tekken, et 2,1 fois plus en chinois.
- Les langues régionales n’y gagnent rien : par rapport à Tekken, il faut 3,7 % de tokens en plus en breton, 7,1 % en corse et 5,6 % en occitan.
- Réentraînée avec un vocabulaire de taille comparable (32 768 contre 32 000 tokens), la même recette ne fait pas mieux que le tokenizer de CroissantLLM, un modèle bilingue français-anglais entraîné sur un corpus bien plus large.
- Adopter un nouveau tokenizer oblige à réentraîner au moins les embeddings d’un modèle, avec un coût de calcul et un risque sur la qualité qui restent à mesurer.
- Le prototype regroupe les chiffres par trois, ce qui pourrait nuire à l’arithmétique des modèles. Ce point n’a pas été testé.
- Les comptages de Claude passent par un point d’accès qu’Anthropic décrit comme une estimation.
Le prototype relève donc d’un compromis de spécialisation, comme l’écrit l’auteur : ce qu’il gagne en français, en anglais et en Python, il le paie dans les autres langues. J’apprécie qu’il publie aussi la comparaison qu’il ne gagne pas, face à CroissantLLM.
Ce que cela change si vous travaillez en français avec une IA
En 2026, travailler en français avec un grand modèle de langage demande encore 31 % à 58 % de tokens de plus qu’en anglais, et environ le double de l’anglais pour le breton ou le corse. Une partie de cet écart tient aux tokenizers, puisqu’un tokenizer entraîné avec assez de français le réduit.
J’en tire deux réflexes pour une organisation francophone. D’abord, comparer les fournisseurs sur le coût d’un document type, mesuré dans sa langue de travail, puisque les tokenizers ne découpent pas tous aussi finement. Ensuite, chiffrer les usages agentiques sur une session complète, là où jouent les paliers tarifaires et la fenêtre de contexte.
À ce stade, rien ne montre encore qu’un tokenizer pensé pour le français réduit le coût d’une tâche correctement accomplie par un modèle. C’est l’étape suivante annoncée par Thomas Serval, en commençant par le français de la banque et de l’assurance.
Qu’est-ce qu’un token dans un modèle de langage ?
Un token est un fragment de mot produit par un tokenizer, l’outil qui découpe le texte avant qu’un modèle le lise. Les modèles facturent au token et leur fenêtre de contexte se compte en tokens.
Combien de tokens en plus le français consomme-t-il par rapport à l’anglais ?
Entre 31 % et 58 % de plus pour un contenu identique, selon le tokenizer. La mesure de Thomas Serval porte sur sept tokenizers de 2026 et sur 1 997 phrases de presse traduites (corpus NTREX-128).
Pourquoi le français consomme-t-il plus de tokens que l’anglais ?
Pour deux raisons qui se multiplient. Les traductions françaises comptent 18 % de caractères de plus que l’anglais, et à nombre de caractères égal le français demande encore 11 % à 33 % de tokens en plus selon le tokenizer.
Quel tokenizer est le plus économe en français ?
Parmi les sept tokenizers mesurés, c’est Tekken, celui de Mistral, avec 31 % de tokens de plus que l’anglais. Celui de Llama 3 est le plus coûteux, à 58 %. Le prototype Baracoda FR v1.2 descend à 20 %, mais c’est un tokenizer seul, sans modèle entraîné avec.
Le français coûte-t-il plus de tokens que le chinois ?
Oui, sur six des sept tokenizers mesurés. Le chinois simplifié va de 5 % de tokens en moins que l’anglais à 40 % de plus, et seul Tekken, le tokenizer de Mistral, traite mieux le français que le chinois.
Combien de tokens pour le breton, le corse ou l’occitan ?
Les langues régionales et ultramarines de France demandent environ 1,6 à 3,3 fois le nombre de tokens de l’anglais. L’occitan est autour de 1,7 fois, le breton et le corse autour du double, le picard, le wallon et le tahitien entre 2,5 et 3,5 fois. Ce sont des ordres de grandeur, mesurés sur un seul texte par langue.
Ce surcoût en tokens se retrouve-t-il sur la facture ?
L’étude mesure des tokens et ne s’appuie sur aucune facture réelle. À prix par token constant, le surcoût est proportionnel sur une requête courte. Dans la simulation d’agent du papier, il dépasse 100 % en cumulé lorsqu’un prompt français franchit plus tôt un palier tarifaire. Le coût complet d’une tâche dépend aussi des sorties et de la qualité, que l’étude ne mesure pas.
Peut-on réduire le nombre de tokens du français ?
Oui, en partie. Dans l’expérience contrôlée, un tokenizer entraîné avec 25 % de français ramène la surtaxe d’environ 1,82 à 1,17, et le prototype Baracoda FR v1.2 utilise 11,5 % de tokens de moins que Tekken. En contrepartie, il en consomme davantage en espagnol, en allemand et en chinois, et son adoption impose de réentraîner au moins les embeddings d’un modèle.
À propos de l’étude
Référence : Thomas Serval, « The Invisible Language Tax: Token Premiums of French and Regional Languages in 2026 LLM Tokenizers, and a French-Optimized Prototype », arXiv:2609.39001v1, 30 septembre 2026.
Les fichiers du tokenizer, les scripts et les comptages phrase par phrase sont publiés sur GitHub, sous licence Apache 2.0 pour le code et CC BY 4.0 pour les résultats. L’auteur précise que mesures, analyses et rédaction ont été réalisées avec l’assistance de systèmes d’IA.